一家人工智能时代的“面粉加工厂”│2026寻找新质生产力领跑者案例
■中国工业报社左宗鑫
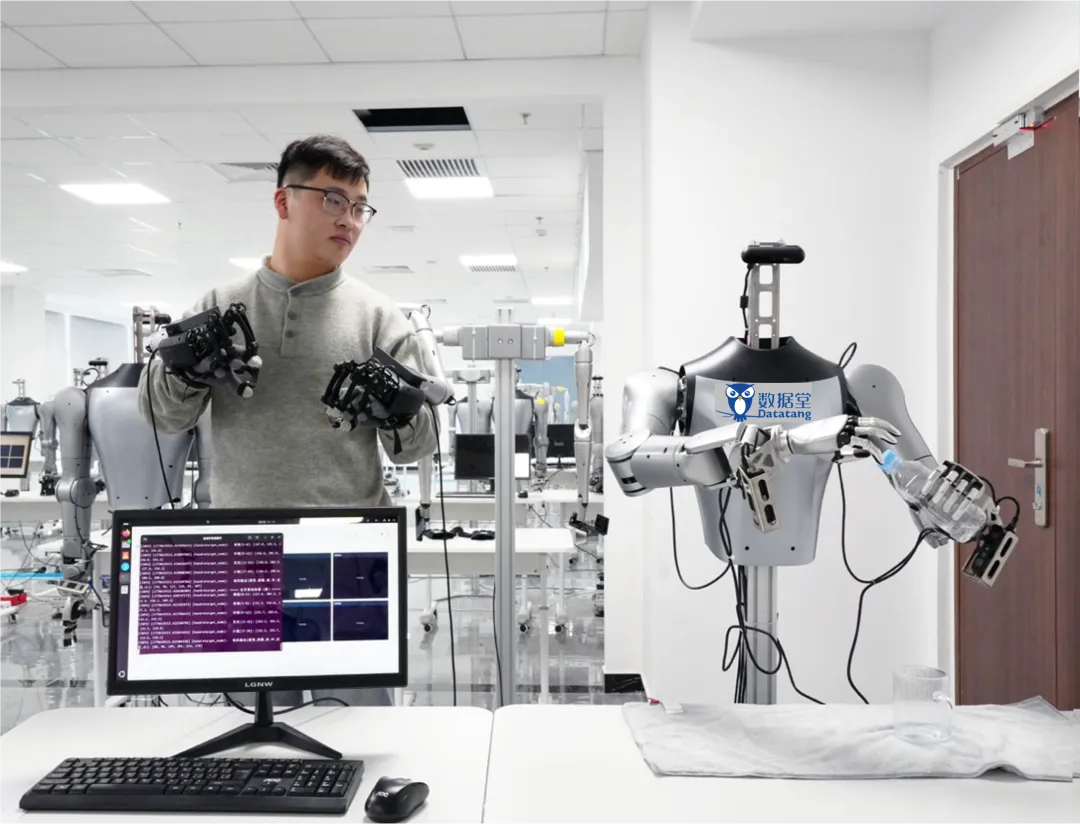
在保定高新区科技产业园,在面积超过8000平米的具身智能数据采集场内,一条专业的数据生产线持续运行。一名操作人员抬起手臂、手指缓缓收拢,另一侧的灵巧机械手几乎同步完成——转腕、移动、放下,操作人员的每一个细微动作、每一丝力控变化,都被头戴设备、数据手套和多目摄像头完整记录。
这看似枯燥的动作背后,产出的是整个AI产业的底层核心资产。当语言大模型的训练数据趋于饱和,具身智能正面临着前所未有的“数据荒”。成立于2010年的数据堂(北京)科技股份有限公司,从语音、图像数据处理起家,服务过上千家AI企业,用数据堂公司董事长、CEO齐红威博士的话说,大模型厂商做的是“面包”,而他们开的是一家“面粉加工厂”。
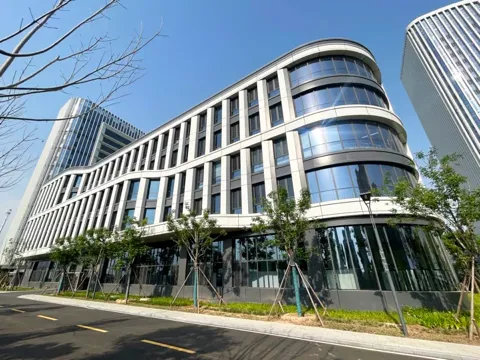
日前,中国工业报社“2026新质生产力领跑者案例调研组”走进数据堂(北京)科技股份有限公司,探寻这家国家级专精特新“小巨人”企业如何将十数年积累的数据生产能力延伸至物理世界。
从“找数据的人”到“做数据的人”
“我们几个创始人原来都是人工智能专业出身。我毕业于中国科学院自动化所,其他人分别来自中科院计算所、北科大等,我们算是国内较早一批从事人工智能数据相关工作的。”谈起创业史,齐红威博士的叙述很平淡。
但这份“平淡”背后,是一条几乎与人工智能学科发展时间线重叠的履历。齐红威博士2004年获中科院自动化所人工智能与模式识别专业博士学位,此后在中科院计算技术研究所从事博士后研究,并曾赴斯坦福大学计算机系做访问学者;2008年至2011年,他担任NEC中国研究院智能信息处理研究部部长、高级研究员。用他的话说:“我从读硕士开始搞人工智能,那时候是专家系统;读博士的时候是统计学习;快毕业时是神经网络;工作期间是深度学习;到现在是大模型——人工智能技术发展的整个脉络,我基本上都走过来了。”
这样一支“做算法出身”的团队,为什么最终却选择去做数据?转折点源于找不到数据。早年,齐红威团队在进行各类人工智能技术应用开发时,让他们感到“痛苦”的,不是模型不够强,而是找不着好的数据。齐红威回忆,“近年来,大家才觉得,人工智能背后的核心是数据,但在此之前大家没这个认知。我们觉得数据的价值更高,数据堂也因此得名,专做人工智能的数据。”
十多年过去,数据堂始终坚持自己的定位:不做算法,不做算力,只围着数据转。“我们完全是围着数据在做。公司花的最大力气,是做版权数据。”齐红威表示,截至目前,数据堂在版权数据上的累计投入已接近10.3亿元,近年来每年新增投入约1.5亿元,每年通过自有数据生产平台执行约7000个项目。
一家因“找不到数据”而创办的公司,最终变成了整个行业都要来找它购买数据的公司。
AI时代的“面粉加工厂”
在齐红威博士看来,华为、阿里、字节、百度这些大模型厂商犹如面包店,他们制作出精美的面包、汉堡;而数据堂要做的事情,就是把五谷杂粮精细打磨成“面粉”,供应给面包店。
“磨面粉”的第一道工序,是拿到“粮食”。据了解,数据堂与多家出版社、图片网站、视频网站已建立战略合作,可合规获取大量原始数据。第二道工序是加工:图表、公式需转换成计算机能理解的格式。对此,数据堂选择“自动化加人工”两条腿走路,因为只靠人工,成本太高;而只靠自动化,质量又达不到。第三道工序,是知识注入。“我们要把题目解析过程列出来,你是怎么解决这个问题的,需要全部标注出来。”齐红威博士举例道,如做数学数据集时,一个符号不能少,数学是非常严谨的领域,缺一个符号就会出问题。
这种变化背后,是整个数据标注产业的升级。当前,数据标注产业已从过去主要靠人海战术的劳动密集型,转向了靠技术和专业知识驱动的知识密集型、技术驱动型。在数据堂,记者对这句话有了形象的认识:为语言大模型生产数学、物理、化学、工程技术类专业题库的,是数学、物理、化学专业的硕士、博士,甚至包括一线教师;而为自动驾驶做标注,则要从“框出障碍物”的传统感知标注,升级为“像老司机一样理解路况、选择路线”的语义标注、认知标注。
升级的效果,直接体现在大模型的“考试成绩”上。齐红威提供了一组直观的观察:“2024年国内大模型做北京高考卷只能考到110—140分;2025年普遍能到640分左右;今年不出意外的话,可以达到700分以上。”他认为,语言模型基本已经学完了“本科生阶段”的知识,再喂以粗浅雷同的数据“起不到促进,反而会拉低智力”,行业已从“以量取胜”转向“以质取胜”,原来动辄几千万篇语料,如今几十万道、甚至几万道高质量题目就会拉开价值差距。
这条“面粉加工线”也得到国家政策的支持。2024年5月,国家数据局确定成都、沈阳、合肥、长沙、海口、保定、大同7个城市承担国家级数据标注基地建设任务,数据堂正是保定基地的核心企业之一。据新华社报道,7个基地数据标注总规模已达17282TB,相当于中国国家图书馆数字资源总量的6倍左右;已形成医疗、工业、教育等行业高质量数据集335个,可赋能121个国产大模型研发,标注从业人员达5.8万人,带动相关产值超过83亿元。
值得注意的是,数据堂企业内部一套覆盖数据采集、清洗、标注、质控、管理、交付乃至领域模型构建的生产平台,原本是“非卖品”,但这两年也发生了变化:传统行业在“人工智能+”行动推动下纷纷启动智能化转型,却发现数据出不了域、云上方案用不了,于是数据堂开始把这套投入约1.6亿元、迭代了14年的数据柔性生产平台进行私有化部署,输出客户覆盖中航工业、国家电投、中国联通等一批央企、国企。
数据堂是国内第一家设立“首席数据保护官”专职专岗的企业。数据堂将安全合规视如企业生命:采集环节践行众包授权与合作合约体系,标注生产的数据集主动申请国家知识产权局“数据知识产权登记证书”,服务模式上践行“原始数据不出域、数据可用不可见”。此外,公司及齐红威博士参与了科技部、国家数据局等多项重大项目攻坚,以及数据领域多项国家标准的起草。在齐红威博士看来,数据安全合规是永远无法妥协甚至协商的底线。
具身智能万亿赛道的数据之争
如果说语言和多模态数据的争夺是“存量精耕”,那么具身智能的数据争夺,就是一场从零开始的“荒地开垦”。
齐红威把人工智能要攻克的基础模型归纳为三类:语言模型、多模态模型,以及具身模型(或称“机器脑”“世界模型”)。前两者已有一定的积累:对于语言模型而言,业内有人类几千年积累的图书、文献、期刊、教材、论文学习;对于多模态模型而言,业内有电影、电视剧、综艺节目可用。但转到具身智能,“很不幸,没数据可用。”
政策也在放大这场数据之争。2025年8月,国务院印发的《关于深入实施“人工智能+”行动的意见》提出,到2027年,新一代智能终端、智能体等应用普及率超70%;到2030年,新一代智能终端、智能体等应用普及率超过90%。在齐红威看来,这份文件里的两个关键词对应两条赛道:“智能体”解决数字世界的脑力问题,而“智能终端”金字塔的塔尖是具身智能,更核心的是人形机器人。“人类的大部分工作还是在现实世界,家居、工厂、银行、医院、超市将来都可能被机器人介入,这个场景远比数字世界大得多。”齐红威认为。
那么,具身智能到底缺哪几类数据?数据堂把具身智能的数据分成了三类:一是“大脑决策数据”,让人模拟机器人,戴上头环和摄像头,把人手工作的全过程记录下来,后期通过视觉重建还原每个手指的位置、速度与配合,再逐步标注“第一步干什么、第二步干什么”,相当于给机器人编写教材;二是“控制数据”,在数据堂保定具身采集工场,操作员通过遥操设备驱动灵巧手拆装螺丝、搬箱子、剥橘子,把手部每个环节的动作力度、手指配合全部记录下来;三是“场景数据”,机器人需要知道从卧室到厨房怎么走、一路上经过什么。
采集方式上,数据堂采取“场内+场外”双轨:场内在保定自建8000平方米采集基地,部署150套灵巧手操作设备;场外则把设备精巧化、简单化,让保洁阿姨、工厂产线工人带上Ego设备“该怎么干活还怎么干活”,同时用六目摄像头把整个过程录下来,再靠视觉重建把每根手指抽出来训练机器人。
这片开垦的市场规模有多大?齐红威给出了一组测算:2026年,具身智能数据约在百万小时级别;2027年可达千万小时级别;未来市场需求会到5亿乃至10亿小时。“若按100元/小时计算采集成本,那么就是500亿至1000亿元的规模。”齐红威判断,具身智能将是一个“几万亿甚至十几万亿”的市场,数据是其中绕不开的底座。
虽然市场空间广阔,但齐红威不讳言行业当前还处于初级阶段:具身智能的数据标注目前还停留在“原子技能”阶段——尚未进入复杂的“长程任务”训练。齐红威表示,“今年到明年,做模型的企业和做数据的企业还在互相磨合。”
而谈及具身智能何时能跑通“数据飞轮”?齐红威以自动驾驶向记者举例道:“其实,自动驾驶是典型的具身智能,只不过其控制部分简单:前进后退、打方向盘,但感知部分很复杂。”数据堂早年为自动驾驶做的是“看到什么标什么”的感知标注,大模型出现之后,变成“站在上帝视角告诉系统,路况该怎么理解、车道该怎么选”的端到端认知标注,标注员也因此从“高中生就能做”变成了需要多年驾龄的“老司机”。更关键的是,自动驾驶已经跑通了“数据飞轮”的闭环:算法上车后,识别不了的路况被录下来回传实验室,重新标注、重新训练——这套机制,正是具身智能数据的明天。
十多年前,齐红威用“把小麦磨成面粉、卖给做面包的人”解释数据堂是干什么的;十多年后,这个隐喻长出了新的枝叶——五谷杂粮在发生变化之外,面粉加工人员也换成了知识密集型的认知标注专家。
从“找数据的人”到“做数据的人”,数据堂的十多年,恰好也是中国人工智能高速发展的十余年。当具身智能的万亿赛道徐徐展开,决定机器人能走多远的,或许不只是电机与减速器,还有如保定那座8000平米具身智能工厂里,一双双被摄像头记录的手。
 阅读 18次
 参与 0次

 新公网安备 65230102652584号
 服务中心订阅号




评论0